En 2013, un equipo de Harvard metió cien mamografías con historial conocido en el trabajo diario de un servicio de cribado. Cincuenta tenían cáncer. Llevaban nombres inventados y nadie avisó a los radiólogos de cuándo aparecerían. Durante nueve meses las leyeron como cualquier otra, y ninguno dijo haberlas notado. Se les escapó el 30 % de los cánceres. Las mismas imágenes, leídas en una sala de pruebas donde la mitad eran positivas, solo dejaron escapar el 12 %.
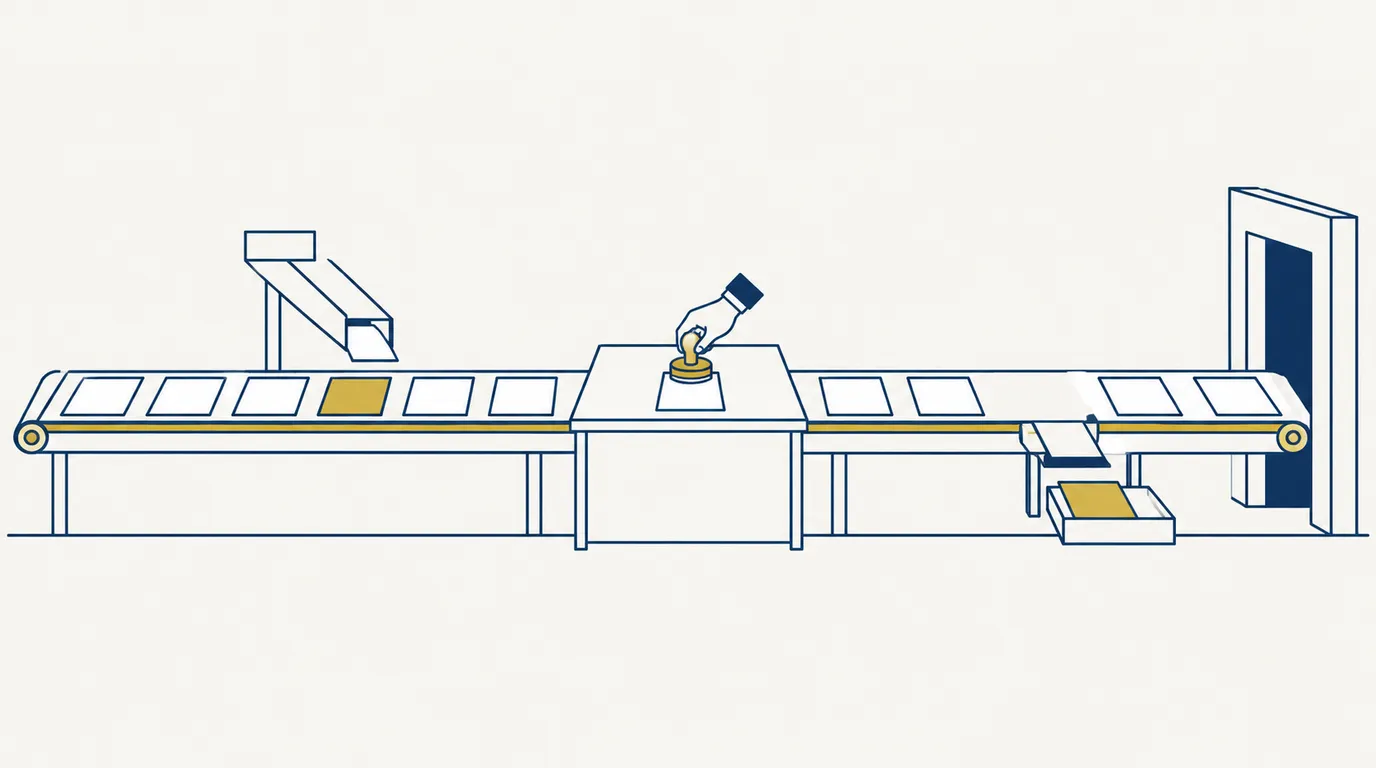
Sin esos casos metidos a propósito, el servicio no habría sabido nunca cuánto se le escapaba. Con la supervisión humana de un sistema de IA pasa lo mismo: si no se le meten errores conocidos, no hay forma de saber si quien supervisa los caza.
Probar la supervisión en seis preguntas
Qué es
Meter salidas erróneas conocidas entre las salidas reales de un sistema de IA y contar cuántas acepta sin corregir la persona que lo supervisa. Mide el sesgo de automatización: la tendencia a dar por buena la salida de la máquina.
- Quién
- El proveedor diseña las medidas contra el sesgo y puede probarlas. El que despliega el sistema pone a las personas que supervisan y comprueba que las medidas funcionan en su casa. Los errores los mete alguien distinto de quien supervisa.
- Cuándo
- Antes de sacar el sistema, y después cada cierto tiempo y tras cada cambio de modelo o de pantalla. Para el alto riesgo del Anexo III, desde el 2 de diciembre de 2027.
- Dónde
- En el trabajo real, no en una sala de pruebas. Los resultados van a la documentación técnica y a la vigilancia del sistema tras su puesta en el mercado.
- Por qué
- El artículo 14 del Reglamento de IA pide que quien supervisa pueda ser consciente del sesgo de automatización. Y en el día a día nadie sabe qué salida era la correcta, salvo en los casos que la propia organización ha metido.
- Cómo
- Con errores realistas, sin aviso de cuándo llegan, interceptados antes de que tengan efecto y con el resultado al momento. Detalle abajo.
Una persona delante no basta
Un metaanálisis de 106 experimentos, publicado en Nature Human Behaviour en 2024, encontró que de media una persona con ayuda de una IA rinde menos que la más fuerte de las dos trabajando sola. La pérdida aparece en las tareas de decidir y cuando la IA es mejor que la persona, que es justo el caso en que se compra una IA. En mamografía, cuando la IA proponía una categoría errónea, la exactitud de radiólogos con más de quince años de experiencia bajó del 82 % al 45,5 % (Dratsch y otros, 2023).
Poner a alguien a supervisar no protege por sí solo. Hay que comprobar que funciona.
Por qué se escapan los errores de una IA que casi nunca falla
Cuanto más raro es lo que hay que encontrar, más se escapa. Jeremy Wolfe lo midió en búsqueda visual: con el objetivo en la mitad de las imágenes se escapó el 7 %; con el objetivo en una de cada cien, el 30 %. Y las respuestas de «aquí no hay nada» se volvían más rápidas. La gente no ve peor: deja de buscar antes.
Una IA que acierta el 98 % de las veces convierte sus errores en eso, en objetivos raros. Quien la supervisa se acostumbra a que todo está bien, y la organización tiene tan pocos errores reales que no se entera de cuántos pasan. Meter errores a propósito arregla las dos cosas: la persona vuelve a encontrar algo de vez en cuando, y la empresa tiene casos con la respuesta correcta conocida para contar.
Hay un segundo efecto, que en ergonomía se llama del leñador: cuanto más alto es el árbol, más fuerte cae. Cuanto más automatizado está un trabajo, mejor va mientras la máquina acierta y peor cuando falla (Onnasch y otros, 2014). Una prueba sin fallos de la IA solo ve la primera mitad.
El precedente: los rayos X de los aeropuertos
Las máquinas de rayos X de los controles de seguridad de la UE están obligadas a proyectar armas y explosivos ficticios sobre maletas reales. Se llama proyección de imágenes de amenaza (TIP, por sus siglas en inglés) y lo exige el anexo del Reglamento de Ejecución (UE) 2015/1998, en su punto 12.5:
- Las amenazas aparecen repartidas, sin posición fija, y nada avisa de que va a salir una.
- La pantalla dice al momento si se acertó, se falló o se dio una falsa alarma.
- El resultado de cada persona se guarda al menos un año y sirve para orientar su formación.
- Las imágenes tienen que ser realistas, y la autoridad lo comprueba.
Lleva años en uso en los controles de seguridad europeos.
Lo que ya se sabe de meter errores
Si el fallo se espera, no mide nada. El informe del accidente del AF447 recoge que las tripulaciones llegaban al ejercicio de simulador conociendo el fallo de antemano, y la investigación pidió meter la sorpresa en los entrenamientos.
Medir funciona; castigar con una lección, no. En la suplantación de identidad simulada (phishing), un estudio con 14.733 empleados de una gran empresa vio que la formación que salía al caer en el engaño no mejoró los resultados, e incluso los empeoró. Lo que sí funcionó fue dar un botón para avisar de correos sospechosos: los empleados detectaron campañas reales en minutos. Un ensayo con 19.500 empleados de la Universidad de California en San Diego encontró que la formación apenas cambiaba nada y que la dificultad del correo pesaba mucho más.
Lo que más ayuda gusta menos. En un experimento de Harvard probaron pantallas que obligan a pensar: dar la respuesta propia antes de ver la de la IA, ver la de la IA solo si se pide, o esperar unos segundos a que aparezca. Cuando la IA se equivocaba, quien usaba estas pantallas siguió el error menos que quien solo veía una explicación de la IA: un 48 % frente a un 64 % en una de las preguntas. En la decisión final la diferencia fue pequeña. Y las pantallas que más ayudaron fueron las peor valoradas.
Cambiar un error por el contrario tampoco sirve. En un estudio con 19 radiólogos veterinarios, quienes daban su respuesta antes de ver la de la IA coincidieron menos con ella, tanto cuando acertaba como cuando fallaba (Fogliato y otros, 2022). Por eso hay que contar también los aciertos de la IA que se rechazan sin motivo.
El error tiene que ir en las dos direcciones. En 2026, 1.339 profesores griegos corrigieron un examen con una nota sugerida errónea. Si la nota era demasiado severa y venía «de la IA», la dejaron pasar más que si venía de un colega. Si era demasiado generosa, no hubo diferencia.
No conocemos ningún estudio que demuestre que convertir esto en un juego reduzca el sesgo de automatización. Sí hay pruebas de que juegos cortos con respuesta inmediata reducen otros sesgos.
Qué pide la norma, y qué no
El artículo 14 del Reglamento de IA, en su apartado 4, letra b, pide que quien supervisa pueda ser consciente del riesgo de fiarse en exceso de la salida del sistema. No dice cómo se comprueba.
La norma europea que lo desarrollará, la prEN 18229-3 (en encuesta pública hasta el 22 de octubre de 2026), va más lejos:
- Obliga al proveedor a diseñar medidas que mantengan a la persona revisando de verdad, y a explicar el riesgo en las instrucciones de uso (apartado 5.5.1).
- Propone, sin obligar, probar esas medidas durante el desarrollo. Su ejemplo es mezclar salidas correctas con otras erróneas a propósito y contar cuántas se aceptan sin corregir (apartado 5.5.2).
- Para las medidas que aplica quien despliega, obliga al proveedor a darle una forma de comprobar que funcionan (apartado 5.4.1).
La guía internacional ISO/IEC 42105, en votación final hasta el 21 de octubre, añade que la formación de quien supervisa no debe quedarse en la inicial y que la pantalla de supervisión se pruebe en situaciones reales. También reconoce el problema de fondo: en el día a día nadie sabe cuál era la salida correcta.
Ninguna de las dos pide seguir metiendo errores cuando el sistema ya está en uso. El cribado de mama dice que es ahí donde salen los fallos de verdad.
Cómo montarlo
- Elegir qué error importa. Sale de los riesgos ya identificados para ese sistema.
- Sacar los errores de fallos reales del modelo, de dificultad variada y en las dos direcciones. Los errores inventados suelen verse a simple vista; los de verdad caen en casos difíciles, donde la persona también duda. Si se reconocen, no miden.
- Interceptar el error antes de que tenga efecto. La persona decide sobre él, pero la salida falsa no llega nunca a un cliente ni a un paciente. Como en el aeropuerto, el error solo existe en la pantalla.
- Avisar de que existen, nunca de cuándo llegan.
- Dar el resultado al momento, sin castigo, y que discrepar de la IA no cueste más que confirmarla. Quien sabe que tendrá que explicar cómo decidió verifica más (Skitka y otros, 2000).
- Medir con los indicadores de abajo y guardar el resultado de cada persona.
- Alternar. Ratos cortos con muchos errores y respuesta inmediata, y el resto del tiempo pocos. Así mantenía Wolfe la atención en los periodos tranquilos.
- Trabajar de vez en cuando sin la IA, para ver si la persona pierde destreza.
- Usar los datos para formar y para cambiar la pantalla. Antes de empezar, hay que revisar con quien lleve laboral y protección de datos cómo informar a la plantilla y a su representación.
Qué medir
| Indicador | Cómo se calcula | Cuidado con |
|---|---|---|
| Errores aceptados sin corregir | errores metidos que se aceptan / errores metidos | Con pocos casos el número engaña: si alguien caza 30 de 30, solo se sabe que deja pasar menos de un 10 % |
| Salidas correctas rechazadas | aciertos de la IA que se cambian / aciertos de la IA | Es el error contrario. Sin esta fila, quien lo rechaza todo parece que supervisa muy bien |
| Anulaciones cuando la IA duda | anulaciones / salidas con confianza baja, separando las acertadas de las equivocadas | Anular mucho y mal es peor que no anular. Y si la confianza que muestra la IA no es fiable, se mide la pantalla |
| Acierto entre dos versiones de la pantalla | acierto final con la versión A frente a la B, en los casos en que la IA se equivoca | Una pantalla que hace aceptar más no supervisa mejor. Las explicaciones suben la aceptación de lo bueno y de lo malo |
| Señales del día a día | tiempo de revisión, coincidencia con la IA y anulaciones de cada persona, sin errores metidos | Un tiempo muy corto con coincidencia casi total delata a quien valida por inercia. Las directrices europeas sobre decisiones automatizadas no aceptan esa participación humana de fachada |
La prEN 18229-3 propone el primero, el tercero y el cuarto para la prueba de desarrollo. Todos sirven con el sistema en uso.
El artículo 14 pide que la persona pueda anular al modelo y que quede traza, como se explica en un humano delante de la pantalla no es supervisión humana. Meter errores a propósito es la forma de saber si esa persona, además de poder, lo hace.